「AIは声優の仕事を奪わない」ElevenLabsが考える、“声のアイデンティティ”を世界へ届ける可能性
独自のディープラーニング技術による圧倒的な自然さと豊かな感情表現で音声AI業界をリードするElevenLabs。2022年に米国で設立された同社が、先日開催された『第2回AI日本国際映画祭』(『AI Film Festival Japan 2026』、以下『AIFJ』)にて協賛特別賞(最優秀音声表現賞)を新設した。
映像作品における音声AIの存在感は日に日に増しているが、現在の音声AIは人間の複雑な感情にどこまで肉薄しているのか。 本インタビューでは、ElevenLabs Japan 合同会社 Head of Marketing - Japan, Korea & Singaporeの寺村ジャック氏に話を聞いた。今回のAIFJノミネート作品から感じた音声AIの活用傾向の話題を入り口に、ElevenLabsの徹底した権利保護の仕組みや声優の可能性を広げる新たなビジネスモデルなど、音声AIと声優のかかわりにおける課題と描く未来についても掘り下げていく。(編集部)
AI映画で声を大切にしている作品が増えている

ーー今回の『AIFJ』では、ElevenLabsによる協賛特別賞「 最優秀音声表現賞(Best Use of Voice)」も設けられ、10作品がノミネートされました。ノミネート作品の音声の使い方には、どのような傾向が見られましたか?
寺村:ファイナリストに選ばれた方は、皆さん相当レベルが高いと思いました。そのため、どの作品を見ても音声の使い方にそこまで強い違和感を覚えたものはありませんでした。
強いて言えば、使用している言語に慣れ親しんでいないせいでたまに読み方が間違っているなど、TTS(テキスト・トゥ・スピーチ)固有のAI的なエラーを感じる作品もあるにはあったというくらいです。ただ、そこはあまり減点の対象にしないようにしていました。
ーーでは、どのような点を評価の対象として見ていたのでしょうか?
寺村:評価のポイントとして見たのは、ストーリーに対して声のトーンや演技のレベルが十分なものになっているかどうかです。また、我々は効果音や音楽も手がけているので、映像の中に含まれる効果音や音楽が「物語への没入を十分に支えていたか」「逆に過剰になっていなかったか」というところをなるべく見るようにしていました。とはいえ、どうしても客観的な評価が難しいので何度も何度も見て悩みました。
ーーこのアワードだけでなく、AI映画全般において、音声の使い方のレベルは、年々上がってきているのでしょうか?
寺村:AI音声が自然にしゃべれるようになったことで、映像に登場するキャラクターに個性を宿そう、魂を吹き込もうと考えるクリエイターさんが増えてきている印象です。その結果、声をとても大切にしている作品も増えてきたと感じています。
また、細かなプロンプティングができるようになったことで映像自体のレベルも上がっていますが、音に関してもこだわりのある方はとても丁寧にプロンプティングされているという印象を強く持っています。
ーー個人でAI映画を作る人が、音声の面で一番つまずきやすいのはどこだとお考えでしょうか?
寺村:おそらく演技だと思います。我々が普段しゃべっている会話の声のトーンやアクセントにももちろん抑揚はありますが、映像作品になるといわゆる演技が入ってきます。ただ、AIを使って映像作品を作っている方の多くは、プロの俳優や声優のように、演技や声の世界で経験を積んできたわけではありません。
そのため、どの程度まで演技に強弱を持たせないと映像作品として単調に聞こえてしまうのか、あるいはやりすぎになってしまうのか、その線引きがまだ分かりにくいのだと思います。声の演技の部分は経験があるかないかで差が生まれやすいところだと感じています。
映像生成AIと音声AIは「統合」か「共存」か
ーーElevenLabsは、昨年11月に他社の映像生成AIや画像生成AIも自社のツールで使えるように統合した「ElevenLabs Image & Video」を公開しました。今後、業界として映像生成AIや音声AIは、それぞれの分野に特化したツールとして展開されていくのでしょうか。それとも、ひとつのツールの中で映像も音声も扱える形に統合されていくのでしょうか?
寺村:個人的にはどちらか一方というよりも、それぞれの分野に特化したモデルが互いに協調しながら共存していく形になると思います。というのも、我々の音声モデルは音声に特化して開発しているからこそ、今の一般的なAIがおおよそできるTTSの発話の自然さを一段超えて感情表現を豊かにしたり、人間らしくしたりするところに強みを発揮できているからです。餅は餅屋ではないですが、我々のように音声モデルだけを研究開発しているところにはやはりそのアドバンテージがあると考えています。
一方で音声を使う目的のひとつである映像については、我々が今から映像のモデルを開発したとしても、すでに先行している企業に対して投資対効果が見合いません。だから、そこは協調する関係になり映像は映像で優れたモデルを使いながら、音声には我々のモデルを使うことで、ひとつのきれいな映像作品を作る、という形になっていくだろうと思います。
ーー現状、競合他社にもそういった動きが見られますか?
寺村:他社さんもTTSをやっていないわけではなく、独自に開発はされています。ただ、業界が統合と共存のどちらに傾くかはおそらく誰にも分からないと思います。その理由は、映像も音声も通常のLLMとは違って、ゴールの終着点がもう少し分かりやすいからです。たとえば音声であれば、我々が今会話しているこの状態が音声AIモデルの最終的な終着点です。
そう考えるとあと少しの余白しか残っていないとも言えますが、その少しの余白を埋めるのが、実は非常に難しい。カーブで言うと、途中まではなだらかに上がってくるものの、90点を超えたあたりから残りの10点を埋める作業にはかなりの手間がかかるという状態です。
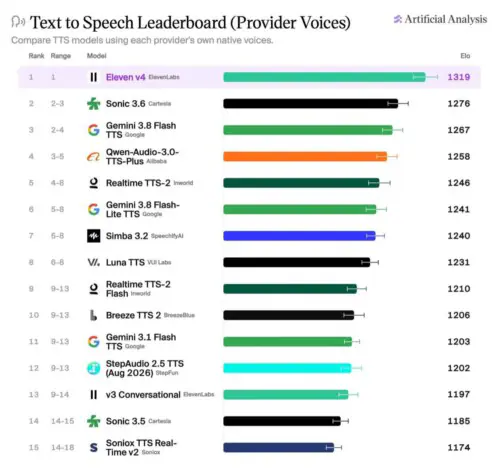
そうしたなかで、我々が最近公開した「Eleven v4」と、短いレイテンシーで生成できる「Eleven v4 Turbo」というモデルがArtificial AnalysisのProvider Voice Arenaで1位・2位に位置しています(2026年11月10日確認)。これをやり続けるのは専業ではないベンダーからすると、かなり大変な作業だと思います。全部を統合したいという思いはもちろん皆さんにあると思いますが、現実的にそれが簡単かというとそうではないと感じています。
AIは声優の仕事を「代替」しない
ーー技術面で言えば、残りの10点を埋めるのが大変だというお話もありましたが、人間の俳優が持つ息遣いやためらい、泣きながら笑うような複雑な感情に対して、ElevenLabsのAI技術は、現在どこまで肉薄できているという認識でしょうか?
寺村:今挙げていただいたような感情に関しては、おそらくすべて表現できていると思います。逆に、言葉で説明しづらいような感情を表現するのは、難しい可能性があります。
ーーでは、泣きながら笑うような感情は、どのように指示するのでしょうか?
寺村:我々のツールには「オーディオタグ」というタグ機能があり、それをセリフの前後に挟むことで「このセリフはこのように読んでほしい」という演技指導ができます。タグがない状態でも、文脈を理解して「ここはこう読むんだろうな」とある程度予測しながら人間らしく読めるのですが、「泣きながら笑うようにここを読んで」という場合のように、より強く指定したいときには、そういう指示が出せます。
この指示も結局は自然言語で出すので、その指示の出し方で伝わる感情表現であれば今のv4でかなり高いレベルまで表現できるようになりました。実際、「泣きながら笑う」は、まさに我々がよくデモンストレーションでお見せしている表現です。他にも「陰鬱とした感じで」「少し後ろめたい気持ちで」といった指示もうまく表現しようとしますが、皆さんが求めるレベルになっているかどうか、ぜひ実際に試していただければと思います。
ーー人間が言葉で伝えられる程度のものであれば、v4ではほぼ表現できるという感じなんですね。では逆に、ElevenLabsにとってまだ実現できていないことや、今後の挑戦だと考えているのはどのようなところでしょうか?
寺村:まずお伝えしたいのは、我々はこの技術がよく言われる「声優さんの仕事を代替する」ものだとは思っていないということです。その証拠に、いろいろな声優さんと連携しながら製品開発などを進めています。
声優さんのすごいところは、通常であれば「ここはこう読むよね」という多くの人が想像しうる演技とは少し違う演技を加えることで、個性やキャラクターを引き出せることだと思っています。それは結局、声優さん自身が持っている知識や経験の積み重ねのなかから出てくるものなので、アマチュアの方がAIで作ろうとしてもうまくいかないこともあります。そのため、ユーザー側のすべてのニーズに応えられる音声をElevenLabsで開発できるかというと、今の時点では必ずしもそうではないと感じています。
声優の仕事が増える使い方の提案を
ーーElevenLabsに限らず、音声AI業界全体としてはどのような課題があるのでしょうか?
寺村:ElevenLabsでは、本人の同意と声の権利保護を重視して取り組んでいますが、音声AIがさまざまな方のパブリシティ権の侵害につながるケースがあり、そうしたニュースを見かけることも増えました。そのため、音声AIに向けられる視線にはやや冷ややかなものもあると感じています。そこを業界のリーダーとしてどう乗り越えていくかがひとつの課題だと思います。
ーーパブリシティ権の話がありましたが、ElevenLabsは声のクローンは本人の同意が前提だという方針を掲げており、昨年には声優事務所の81プロデュースとも提携しています。また今年は、声優の梶裕貴さんがプロデュースするAIキャラクター「梵そよぎ」の英語音声をElevenLabsが生成し、展覧会「記憶汚染展」の英語版音声ガイドに使われたことも話題になりました。こうした取り組みを含めて、声の権利を守る仕組みは現在どこまで整っているのでしょうか?
寺村:ひとつは、Professional Voice Cloning(PVC)における本人確認です。PVCは本人の声を対象とし、登録時にその場で読み上げた声とアップロードした音声を照合します。作成した声は、ご本人がVoice Libraryで一般公開するか、共有リンクで限定的に共有するかを選べます。なお、Instant Voice Cloning(IVC)では、対象の声をクローンする権利と同意の確認が前提となり、PVCとは登録の仕組みが異なります。
ーーもうひとつはどのような仕組みでしょうか?
寺村:もうひとつは、生成元の確認を助ける電子透かしやAudio Detectorです。Audio DetectorではElevenLabsの電子透かしを検出し、見つからない場合にはAI Speech Classifierによる推定も行います。ただし、対象や検出精度には制約があり、判定結果だけで本人の許諾や権利侵害の有無が分かるわけではありません。透かしが検出されないことだけを理由に、無断利用だと断定することもできません。本人確認と生成元の確認など、役割の異なる対策を組み合わせ、声の権利保護に取り組んでいます。
ーー声を提供する側の声優や事務所の受け止め方は、そうした仕組みが整い始めたことで、どのように変わってきていますか?
寺村:大きく言えば、業界的にも受け入れようとする流れは徐々に広がりを見せ始めている印象があります。だからこそ、法務省からも、声の無断利用とパブリシティ権などの関係を整理した解釈指針が公表されるなど、権利保護に向けた動きが進んでいます。
一方で、皆さんが同じレベルでこういった仕組みのことを理解されている段階まではまだ来ていないので、「何がなんでも自分の声が機械に使われるのは気持ち悪くて嫌だ」と否定的に見る方もまだまだいらっしゃいます。我々の立場としては、これからそうした見方が徐々に変わっていくことを期待しています。
ーー声を提供する側にとってのメリットはどういったところにあるのでしょうか?
寺村:ひとつは収益化できるということです。ご本人が作成・確認したProfessional Voice CloneをVoice Libraryで公開し、報酬の受け取りに必要な設定・条件を満たすことで、対象となる有料ユーザーの利用量などに応じて報酬を得られます。無料ユーザーによる利用は報酬の対象外です。
それと有名人の場合は別のメリットもあります。有名人の声はそもそも一般公開されないケースがほとんどです。これは有名人本人が自分の声のアセットをどう扱うかによりますが、こうした方々が声のデータを提供するときには当然ビジネス上の取り決めがあります。ElevenLabsではそうした場合に「このプロジェクトで自分の声のデータが使われるなら、使用料はいくら」というように、声を使用するための条件を設定することもできます。
ーー声優自身にとっては、どのような可能性が広がるのでしょうか?
寺村:我々が声優の皆さんによくお伝えしているのは、仕事を奪おうとしているのではなく、むしろ仕事が増えることが期待できる使い方のご提案です。たとえば、お忙しい声優さんだと「この現場にいなければならないのに、同時にいくつも案件の依頼が来ていてそちらの収録はできない」ということがあります。そういった場合でも声のデータを提供さえしていれば、自分が現地にいなくても仕事を受けられる可能性があります。
ーーなるほど。梶裕貴さんの「梵そよぎ」のような形は、それに近いと思いました。
寺村:そうですね。自分がいなくても、そこに自分の声というアイデンティティを置いておけるわけです。そういった形で今までよりも声優さんがたくさんの仕事を受けられるようになると考えています。
また、日本では吹き替え映画の文化が非常に強く、海外の作品は日本の声優の声で聞きたいという層が一定数いらっしゃると思いますが、逆に日本の映画に外国語の吹き替えを付けることは、あまりありません。外国の方だって日本の映画を見る機会があって、自分の言語で理解できるなら見たいと思っている人もいるはずです。そう考えると、そこには声優本人の声のまま外国語に吹き替えるというニーズがある。それに応えることで、日本のコンテンツを世界に届けられる可能性は大いにあると思います。

音声AIは「自分らしさ」をどう変える? Parakeet中村泰貴氏が語る、声色と表現の可能性
音声AIは、表現やコミュニケーションをどう広げるのか。「AI荒井由実」やリアルタイムAIボイスチェンジャー「Paravo」を手が…